 Kamil Lee의 개발 일기

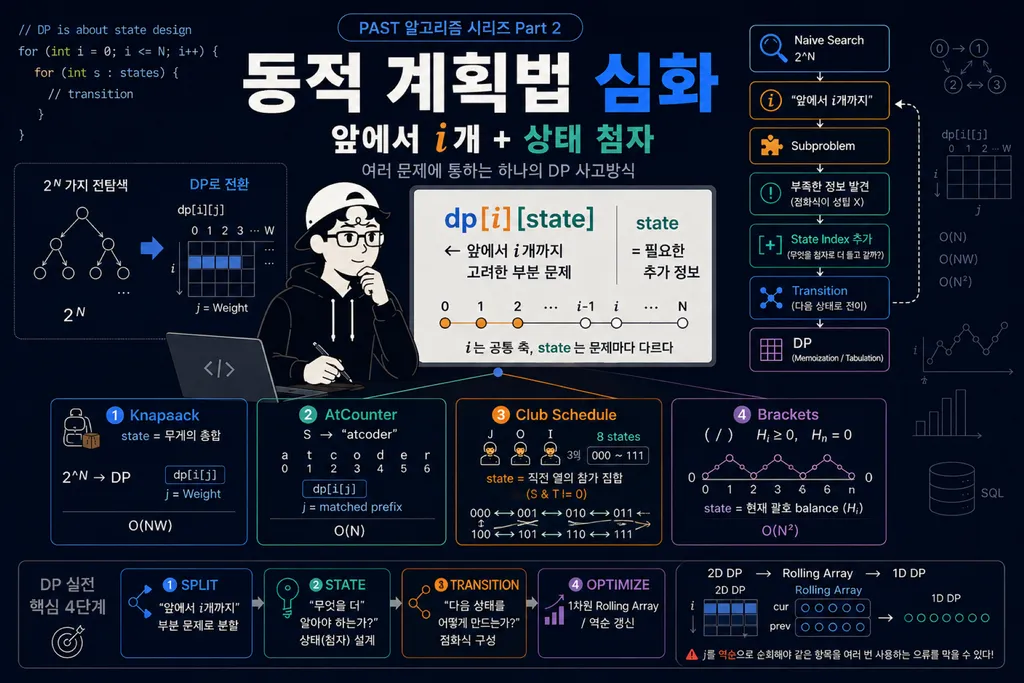
- 이 글은 Part 2 — 동적 계획법 심화 ① 의 보충편입니다. 본편에서 지면상 접어 둔 곳을 펼칩니다. 앞선 보충편은 배낭 문제 풀이입니다.
- 소재는 「アルゴリズム実技検定 公式テキスト [上級]~[エキスパート]編」(이하 "서적")의 예제 2-2-1, 즉 競プロ典型90問 008번 문제입니다.
- 본 시리즈의 코드 예제는 Java로 재작성되었습니다. 서적의 원본 소스코드(Python)는 Github 리포지토리에 있습니다.
이 글을 쓰는 이유
이 문제는 본편에서 유일하게 손 추적 표가 실린 예제입니다. 다만 그 표는 목표 문자열을 "atc"로 줄이고 $S = $ "aatctc"로 둔 축소판이었습니다. 감을 잡는 데는 충분하지만, 진짜 문제를 풀 때 걸려 넘어지는 곳은 따로 있습니다.
- 서적과 AtCoder가 제시하는 진짜 예제는 $S = $
"attcordeer"이고 답은 4입니다. 그런데 각 글자의 등장 횟수를 곱하면 $1 \times 2 \times 1 \times 1 \times 1 \times 2 \times 2 = 8$입니다. 어디서 절반이 사라졌을까요? - 2차원 점화식은 "뽑는다 / 뽑지 않는다" 두 갈래였는데, 본편의 1차원 코드에는 갱신이 하나뿐입니다. "뽑지 않는 경우"는 어디로 갔을까요?
- 본편은 "$j$를 역순으로 돌아야 한다"고 강조했습니다. 그런데 이 문제는 정순으로 돌려도 정답이 나옵니다. 왜일까요? 그리고 언제부터 역순이 진짜로 필요해질까요?
- $N \leq 10^6$은 실제로 무엇을 금지하고 있을까요?
이 글은 그 네 가지에 답합니다. 본편과 겹치는 부분은 2절에서 압축하고 넘어가겠습니다.
1. 문제를 다시 읽는다 — 제약이 설계를 결정한다
문제 URL
길이 $N$의 문자열 $S$가 주어집니다. $S$에서 몇 글자를 뽑아내는 방법은 $2^N$가지인데, 그중 뽑아낸 글자를 원래 순서대로 나열했을 때 "atcoder"가 되는 것이 몇 가지인지를 $10^9 + 7$로 나눈 나머지로 구합니다.
먼저 확실히 해 둘 것 — 부분수열이지 부분문자열이 아니다
- 부분수열(subsequence) — 순서만 지키면 띄엄띄엄 골라도 된다.
"attcordeer"에서 1·2·4·5·7·8·10번째를 고르면"atcoder"가 됩니다. 이 문제는 이쪽입니다. - 부분문자열(substring) — 연속해야 합니다.
"attcordeer"안에 연속한"atcoder"는 하나도 없습니다.
둘을 헷갈리면 완전히 다른 알고리즘으로 갑니다. 부분수열 세기는 이 글의 DP이고, 부분문자열 찾기는 KMP나 롤링 해시의 영역입니다. 7절에서 이 갈림길을 다시 짚겠습니다.
1편에서와 같이, 제약부터 읽습니다.
| 제약 | 이것이 결정하는 것 |
| $1 \leq N \leq 10^6$ | DP 표의 행 수. 2차원으로 잡으면 약 64MB — 1차원 롤링이 사실상 강제된다. 입출력 속도도 여기서 문제가 된다 |
목표 문자열이 "atcoder"로 고정 |
DP 표의 열 수가 $7 + 1 = 8$로 고정. 계산량이 $O(7N)$으로 묶인다 |
| $S$는 영소문자 | "atcoder"에 없는 글자는 아무 일도 하지 않는다 — 그냥 지나간다 |
| 답은 $10^9 + 7$로 나눈 나머지 | 값이 $10^9$ 남짓. 두 개를 더하면 약 $2 \times 10^9$ — int의 상한에 아슬아슬하게 걸린다 (6절에서 계산합니다) |
2. 본편 요약 — 여기까지는 이미 한 이야기
본편에서 세운 정의와 갱신식만 옮겨 둡니다. 자세한 유도는 본편 2.2절을 봐 주세요.
dp[i][j] ← 문자열 S의 처음 i글자에서 몇 글자를 뽑아 이어 붙이는 방법 중,
그것이 "atcoder"의 처음 j글자와 정확히 일치하는 방법의 개수- 초기 조건 —
dp[0][0] = 1(아무것도 뽑지 않으면 빈 문자열 하나) - $S_i$를 뽑지 않는다 — $dp[i+1][j] \mathrel{+}= dp[i][j]$
- $S_i$를 뽑는다 — $S_i = T_{j-1}$일 때만 $dp[i+1][j] \mathrel{+}= dp[i][j-1]$
- 답 —
dp[N][7]한 칸 - 계산량 — $O(7N)$
3. 진짜 예제를 끝까지 따라가 본다
본편의 축소판 대신, 서적과 AtCoder가 제시하는 실제 예제로 표를 채웁니다.
10
attcordeer     ← 답은 4
행은 "지금까지 본 글자 수 $i$", 열은 ""atcoder"의 몇 번째까지 맞췄는가 $j$"입니다.
| $i$ (본 글자) | $j=0$ | 1 (a) | 2 (t) | 3 (c) | 4 (o) | 5 (d) | 6 (e) | 7 (r) |
| 0 (시작) | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 1 (a) | 1 | 1 | 0 | 0 | 0 | 0 | 0 | 0 |
| 2 (t) | 1 | 1 | 1 | 0 | 0 | 0 | 0 | 0 |
| 3 (t) | 1 | 1 | 2 | 0 | 0 | 0 | 0 | 0 |
| 4 (c) | 1 | 1 | 2 | 2 | 0 | 0 | 0 | 0 |
| 5 (o) | 1 | 1 | 2 | 2 | 2 | 0 | 0 | 0 |
| 6 (r) | 1 | 1 | 2 | 2 | 2 | 0 | 0 | 0 |
| 7 (d) | 1 | 1 | 2 | 2 | 2 | 2 | 0 | 0 |
| 8 (e) | 1 | 1 | 2 | 2 | 2 | 2 | 2 | 0 |
| 9 (e) | 1 | 1 | 2 | 2 | 2 | 2 | 4 | 0 |
| 10 (r) | 1 | 1 | 2 | 2 | 2 | 2 | 4 | 4 |
몇 칸만 소리 내어 읽어 봅시다
- $j = 0$ 열이 끝까지 1 — "아무것도 안 뽑고 빈 문자열을 만드는 방법"은 언제나 딱 하나입니다. 이 열은 갱신 대상이 아니라 모든 것이 흘러나오는 원천입니다.
- $i = 3$에서 $dp[3][2]$가 2로 뛴다 — 3번째 글자가 두 번째
t입니다. 여기서 $dp[2][1] = 1$이 더해져 $1 + 1 = 2$가 됩니다. "a뒤에t를 붙이는 방법이 2번째t를 쓰는 것과 3번째t를 쓰는 것, 두 가지"라는 뜻입니다. - $i = 9$에서 $dp[9][6]$이 4로 뛴다 — 두 번째
e입니다. 마찬가지로 $dp[8][5] = 2$가 더해져 $2 + 2 = 4$가 됩니다.t의 2가지와e의 2가지가 곱해져 4가 된 순간입니다.
$i = 6$ 행에서는 아무 일도 일어나지 않는다
6번째 글자는 r이고, r은 "atcoder"의 7번째 글자입니다. 그러니 갱신식은 $dp[6][7] \mathrel{+}= dp[5][6]$을 시도합니다. 그런데 그 시점의 $dp[5][6]$은 0입니다 — 아직 d도 e도 보지 못했으니까요.
결과적으로 6행은 5행과 완전히 같습니다. 이 r은 문자열 안에 분명히 존재하지만 단 한 번도 쓰이지 못합니다. 4절에서 볼 "곱셈이 틀리는 이유"가 바로 이 칸에 있습니다.
4. 답이 4인 이유 — 곱셈은 왜 틀리는가
가장 먼저 떠오르는 생각은 아마 이럴 겁니다. ""atcoder"의 각 글자가 $S$에 몇 번 나오는지 세서 곱하면 되는 것 아닌가?"
| 글자 | a | t | c | o | d | e | r |
| $S$에서 등장하는 위치 | 1 | 2, 3 | 4 | 5 | 7 | 8, 9 | 6, 10 |
| 가짓수 | 1 | 2 | 1 | 1 | 1 | 2 | 2 |
곱하면 $1 \times 2 \times 1 \times 1 \times 1 \times 2 \times 2 = \mathbf{8}$입니다. 그런데 정답은 4입니다. 정확히 절반입니다.
범인은 r입니다. r은 6번째와 10번째에 있지만, "atcoder"에서 r은 맨 마지막 글자입니다. 즉 d(7번째)와 e(8 또는 9번째)보다 뒤에 있어야 합니다. 6번째 r은 d보다 앞이라 쓸 수가 없습니다. 곱셈은 이 순서 조건을 전혀 모릅니다.
실제로 조건을 만족하는 조합은 정확히 이 4가지입니다.
| # | 고른 위치 (1-based) | t는 |
e는 |
| 1 | (1, 2, 4, 5, 7, 8, 10) | 2번째 | 8번째 |
| 2 | (1, 2, 4, 5, 7, 9, 10) | 2번째 | 9번째 |
| 3 | (1, 3, 4, 5, 7, 8, 10) | 3번째 | 8번째 |
| 4 | (1, 3, 4, 5, 7, 9, 10) | 3번째 | 9번째 |
자유도는 t의 2가지와 e의 2가지뿐이고, r은 10번째로 고정됩니다. $2 \times 2 = 4$입니다.
DP는 순서를 어떻게 처리하는가
주목할 점은, DP 코드 어디에도 "순서를 확인한다"는 문장이 없다는 것입니다. 그런데도 6번째 r은 저절로 걸러졌습니다.
비결은 표를 왼쪽에서 오른쪽으로 한 번만 훑는다는 구조 자체에 있습니다. $i$번째 글자를 처리할 때 참조하는 것은 $i-1$까지의 값뿐입니다. 그러니 "$j-1$번째까지 맞춘 상태"는 반드시 지금보다 앞에서 만들어진 것입니다. 순서 조건이 루프의 진행 방향에 흡수되어 있는 것입니다.
1편의 "조건을 첨자의 범위로 흡수한다"와 같은 종류의 손놀림입니다. 명시적으로 검사하지 않아도 되도록 구조를 짜는 것이 DP 설계의 큰 부분입니다.
5. 1차원으로 접기 — "뽑지 않는 경우"는 어디로 갔는가
본편의 Java 코드를 다시 봅시다. 2차원 점화식은 갈래가 둘이었는데, 여기엔 갱신이 하나뿐입니다.
long[] dp = new long[M + 1];
dp[0] = 1;

for (int i = 0; i < N; i++) {
    char c = S.charAt(i);
    for (int j = M; j >= 1; j--) {
        if (c == T.charAt(j - 1)) {
            dp[j] = (dp[j] + dp[j - 1]) % MOD;   // 「뽑는다」 밖에 없다
        }
    }
}
"뽑지 않는 경우"인 $dp[i+1][j] \mathrel{+}= dp[i][j]$는 사라진 것이 아니라 공짜가 된 것입니다.
2차원에서는 $i$행과 $i+1$행이 다른 메모리였기 때문에, "안 뽑았다"는 사실도 값을 복사해서 표현해야 했습니다. 1차원에서는 행이 하나뿐이라 아무것도 하지 않으면 값이 그대로 남습니다. 그 "그대로 남음"이 곧 "안 뽑음"입니다.
| 의미 | 2차원 | 1차원 |
| $S_i$를 뽑지 않는다 | dp[i+1][j] += dp[i][j] |
아무것도 쓰지 않는다 |
| $S_i$를 뽑는다 | dp[i+1][j] += dp[i][j-1] |
dp[j] += dp[j-1] |
덕분에 "atcoder"에 없는 글자 — "attcordeer"에는 없지만, 가령 z — 를 만나면 안쪽 루프가 일곱 번 비교만 하고 아무것도 쓰지 않은 채 지나갑니다. 3절에서 본 "6행 = 5행"도 같은 현상의 부분적인 모습입니다.
dp[0]은 왜 루프에 넣지 않는가
안쪽 루프가 j >= 1에서 멈추는 것은 실수가 아닙니다. dp[0]은 "빈 문자열을 만드는 방법의 수"이고, 그 답은 어떤 글자를 몇 개 보든 영원히 1입니다. 3절 표의 $j = 0$ 열이 전부 1인 것이 그 증거입니다.
또 $j = 0$까지 내려가면 dp[0] += dp[-1]이 되어 배열 범위를 벗어납니다. 루프 조건과 점화식의 유효 범위가 정확히 맞물려 있는 것입니다.
6. 역순은 정말 필요한가
본편은 $j$를 역순으로 도는 것을 강조하며, 1편의 1차원 배낭과 "완전히 같은 이유"라고 했습니다. 오름차순이면 dp[j-1]이 이미 이번 글자를 소비한 값이 되어 한 글자를 두 번 쓰는 셈이 된다는 것입니다.
설명은 정확합니다. 그런데 실제로 정순으로 바꿔서 제출하면 어떻게 될까요?
이 문제에 한해서는 — 통과합니다
이유는 목표 문자열에 있습니다. "atcoder"는 일곱 글자가 전부 서로 다릅니다.
그러면 어떤 글자 c 하나에 대해 c == T.charAt(j-1)을 만족하는 $j$는 많아야 하나입니다. 즉 한 글자를 처리하는 동안 갱신되는 칸은 최대 한 칸이고, 그 칸이 읽는 dp[j-1]은 이번에 건드려진 적이 없습니다. 갱신끼리 간섭할 방법 자체가 없으므로 루프 방향이 결과를 바꾸지 못합니다.
무작위 문자열 3,000개로 정순과 역순을 비교해 보았을 때, 다른 답이 나온 경우는 0건이었습니다.
그렇다면 역순은 불필요한 미신일까요? 아닙니다. 목표 문자열을 "aa"로 바꿔 보면 즉시 드러납니다.
| $S$ | 정답 | 역순 | 정순 |
"aa" |
1 | 1 | 3 |
"aaa" |
3 | 3 | 6 |
"aaaa" |
6 | 6 | 10 |
$S = $ "aa"에서 "aa"가 되는 부분수열은 1가지뿐인데 정순은 3을 내놓습니다. 같은 글자를 두 번 세었기 때문입니다. 중복 글자가 있는 목표 문자열로 무작위 실험을 2,000회 돌렸을 때 정순은 1,046회 틀렸고, 역순은 0회 틀렸습니다.
여기서 얻을 교훈
이 문제에서 정순 코드가 통과하는 것은 알고리즘이 옳아서가 아니라, 입력이 우연히 반례를 만들 수 없어서입니다. "atcoder"라는 상수 하나에 정당성이 걸려 있는 셈입니다.
이런 코드는 두 가지 방식으로 배신합니다. 목표 문자열이 바뀌는 변형 문제에서 조용히 틀리고, 몇 달 뒤 같은 코드를 재활용할 때 왜 됐는지 기억나지 않아서 또 틀립니다.
1편의 배낭에서는 정순이 즉시 오답을 냈습니다(90이 100으로). 여기서는 오답이 나지 않습니다. 더 위험한 쪽은 후자입니다. 틀리는 코드는 고치게 되지만, 우연히 맞는 코드는 그대로 남기 때문입니다.
7. $N \leq 10^6$이 요구하는 것
1편의 배낭은 $N \leq 100$이라 무엇을 해도 여유로웠습니다. 여기는 $N$이 1만 배입니다. 제약이 실제로 무엇을 금지하는지 봅시다.
| 하려던 것 | 비용 | 판정 |
2차원 long[N+1][8] |
$(10^6 + 1) \times 8 \times 8\,\text{B} \approx$ 64MB | 위험 — 1차원으로 접으면 64바이트 |
Scanner로 입력 읽기 |
$10^6$글자에 대해 정규식 기반 파싱 | 금물 — BufferedReader를 쓴다 |
S.charAt(i)를 $10^6$번 |
호출마다 범위 검사 | 대개 통과하지만, toCharArray()가 안전하다 |
| 안쪽 루프 $O(7)$ | $7 \times 10^6 = 7 \times 10^6$회 | 여유 있다 |
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
int N = Integer.parseInt(br.readLine().trim());
char[] s = br.readLine().trim().toCharArray();   // charAt 을 100만 번 부르지 않는다

final int MOD = 1_000_000_007;
final char[] t = "atcoder".toCharArray();

long[] dp = new long[t.length + 1];
dp[0] = 1;

for (char c : s) {
    for (int j = t.length; j >= 1; j--) {
        if (c == t[j - 1]) {
            dp[j] = (dp[j] + dp[j - 1]) % MOD;
        }
    }
}
System.out.println(dp[t.length]);int로도 되는가 — 아슬아슬하게 된다
1편에서는 long이 반드시 필요했습니다($10^{11}$). 여기서는 어떨까요? 모든 값이 $10^9 + 7$ 미만이므로 더하기 직후의 최댓값은
$$2 \times (10^9 + 6) = 2{,}000{,}000{,}012$$
이고, int의 상한은 $2{,}147{,}483{,}647$입니다. 들어갑니다 — 여유가 $147{,}483{,}635$, 약 7%뿐이지만.
그래도 long을 쓰는 편이 낫습니다. 법이 조금만 커지거나, 세 항을 더하는 변형이 붙거나, 곱셈이 한 번이라도 들어가면 즉시 넘칩니다. 7%의 여유를 믿고 int를 쓰는 것은 6절에서 본 "우연히 맞는 코드"와 같은 종류의 도박입니다.
8. 자주 틀리는 지점 5선
제출 전 체크리스트
- 부분문자열로 읽었다 — 이 문제는 부분수열입니다. 연속일 필요가 없습니다. 문제문의 "뽑아낸 글자를 그 순서대로 나열"이 그 뜻입니다.
dp[0] = 1을 빠뜨렸다 — 모든 값이 여기서 흘러나오므로, 이걸 놓치면 답이 0입니다. 빈 문자열을 만드는 방법이 1가지라는 선언입니다.- 안쪽 루프를
j >= 0까지 돌렸다 —dp[0] += dp[-1]로 범위를 벗어납니다. 5절에서 본 대로dp[0]은 갱신 대상이 아닙니다. - 정순으로 돌렸다 —
"atcoder"에 한해서는 통과하지만(6절), 목표 문자열이 조금이라도 바뀌면 무너집니다. 역순으로 쓰는 습관을 들이세요. Scanner로 $10^6$글자를 읽었다 — 알고리즘이 완벽해도 입력에서 시간을 다 씁니다.BufferedReader를 쓰세요. 이 문제에서 TLE가 났다면 DP보다 입출력을 먼저 의심하는 편이 빠릅니다.
9. 연습 문제
"문자열을 앞에서부터 훑으며 진행 상태를 첨자로 들고 가는" 사고방식이 통하는 문제들입니다.
| 문제 | 출처 | 보는 곳 | 난이도 |
| 008 - AtCounter | 競プロ典型90問 | 이 글의 본체 | ★★★ |
| F - LCS | Educational DP Contest | 부분수열 DP의 정석. 두 문자열을 동시에 훑고, 답을 복원까지 한다 — 1편 6절의 역추적과 같은 손놀림 | ★★★ |
| D - We Like AGC | AtCoder Beginner Contest 122 | 직전 몇 글자를 상태로 들고 간다 — 다음 보충편(部活)의 사고방식과 직결된다 | ★★★★ |
| F - Substrings | AtCoder Beginner Contest 214 | 서로 다른 부분수열을 센다 — 같은 문자열을 두 번 세지 않으려면 무엇이 더 필요한가 | ★★★★★ |
정리
- 곱셈은 순서를 모릅니다. 등장 횟수를 곱해 8이 나왔지만 답은 4였고, 차이는 "쓸 수 없는 위치의
r" 하나였습니다. DP가 이기는 것은 표를 한 방향으로만 훑는 구조에 순서 조건이 흡수되어 있기 때문입니다. - 1차원 롤링에서 "아무것도 하지 않음"은 그 자체로 하나의 갱신입니다. 2차원의 두 갈래 중 하나가 공짜가 되는 것이 롤링의 이득입니다.
- 우연히 맞는 코드를 경계하세요. 정순 갱신이 이 문제에서 통과하는 것은
"atcoder"의 일곱 글자가 전부 다르기 때문이지, 알고리즘이 옳기 때문이 아닙니다. 목표 문자열에 중복이 하나만 생겨도 절반 이상의 경우에서 틀립니다. int도 7%의 여유로 들어가지만, 그 여유를 믿는 것 역시 같은 종류의 도박입니다.- $N$이 $10^6$이면 알고리즘만큼 입출력이 중요합니다. TLE가 났을 때 DP를 먼저 의심하지 마세요.
참고 자료
- 본편: [PAST] Part 2 — 동적 계획법 심화 ①
- 앞선 보충편: Part 2 보충 — 배낭 문제 풀이
- 서적: 「アルゴリズム実技検定 公式テキスト [上級]~[エキスパート]編」 (マイナビ出版, 2023) — 제2장 2.2절, 예제 2-2-1
- 소스코드: tsutaj/pastbook-2-source-code (Github)
- 競プロ典型90問: https://atcoder.jp/contests/typical90
- AtCoder 공식 사이트: https://atcoder.jp
다음 보충편 예고
[PAST] Part 2 보충 — 部活のスケジュール表 문제 풀이 (WIP) 에서는 "열쇠를 누가 가지고 있는가"라는 추적 문제가 집합의 교집합 조건 한 줄로 내려앉는 과정을 따라갑니다. 그리고 이번 글은 답을 dp[N][7] 한 칸에서 읽었지만 그쪽은 마지막 행 전체의 합을 읽습니다 — 똑같이 세는 DP인데 왜 다른지도 정리합니다.